Jev가 뭐지?
하루가 다르게 많은 것들이 나오는 AI 시대, 요즘 핫하다는 Jev가 뭔지 알아봅니다.
하.. Jev 는 또 뭐고 LLM이랑 뭐가 다른데?
요즘 Jev가 핫하다. Jev가 도대체 뭘까?
Jev는 TypeSafe AI가 만든 System One 모델로써, 긴 글을 써주는 챗봇이 아니라 주어진 정보를 특정한 판단 기준으로 판단해주는 모델이다.
우리가 수치를 기준으로 판단을 할 땐 여태껏 해왔던 것 처럼 알고리즘 코드를 작성해 판단할 수 있지만, 코드로 수식화하기 어려운 것들을 판단하는데 적합하다.
예를들어 이메일이 왔을 때, 이메일 내용을 읽고 이 이메일의 감정을 평가하는 기준을 가지고 발신자의 감정이 화남, 기쁨, 보통 등을 판단 해주는 것이다. 이 외에도 이 이메일은 지금 봐야 하는가, 이 카피는 다시 써야 하는가, 이 요청은 어떤 도구로 보내야 하는가 같은 질문에 대한 판단을 빠르게 내려줄 수 있는 것이 Jev다.
분류와 평가를 Claude나 GPT에게 시킬 수도 있지만, LLM은 확률 모델이라 같은 인풋에서도 결과가 조금씩 다를 수 있고 더 많은 생각을 하느라 응답이 느리다. Jev는 맥락과 판단 기준, 그리고 결과가 구조화 되어있으므로 판단 퀄리티가 일정하다.
"Jev가 LLM보다 더 정확하다"는 것은 아니고, 차이는 능력이 아니라 역할과 운영 방식에 있다. 어느 쪽이 나은지는 해당 업무의 정답 데이터로 직접 비교해 봐야 안다.
| 구분 | Claude, GPT, Codex 같은 LLM | Jev |
|---|---|---|
| 주된 역할 | 생성, 설명, 계획, 수정, 도구 조율 | 분류, 선택, 점수화, 통과 여부 판단 |
| 출력 | 자연어 또는 요청한 구조 | 요청할 때 정의한 구조화된 응답 |
| 잘하는 일 | 초안 작성, 아이디어 확장, 복합적인 문제 해결 | 같은 기준으로 반복되는 좁은 판단 |
| 제품에서의 위치 | 작성자, 계획자, orchestrator | judge, classifier, scorer, gate |
| 한계 | 출력이 장황하거나 형식과 판단이 흔들릴 수 있음 | 자유로운 글쓰기나 복잡한 장기 계획에는 맞지 않음 |
Jev, 그럼 어떻게 쓸 수 있는데?
카피의 후킹 가능성을 Jev로 판단해보자
구매를 유도하는 랜딩페이지의 Hero 카피나, 마케팅 캠페인 카피를 평가한다고 해보자.
일단 Jev가 판단을 하기 위해 우리는 맥락과 판단 기준을 정리해야한다.
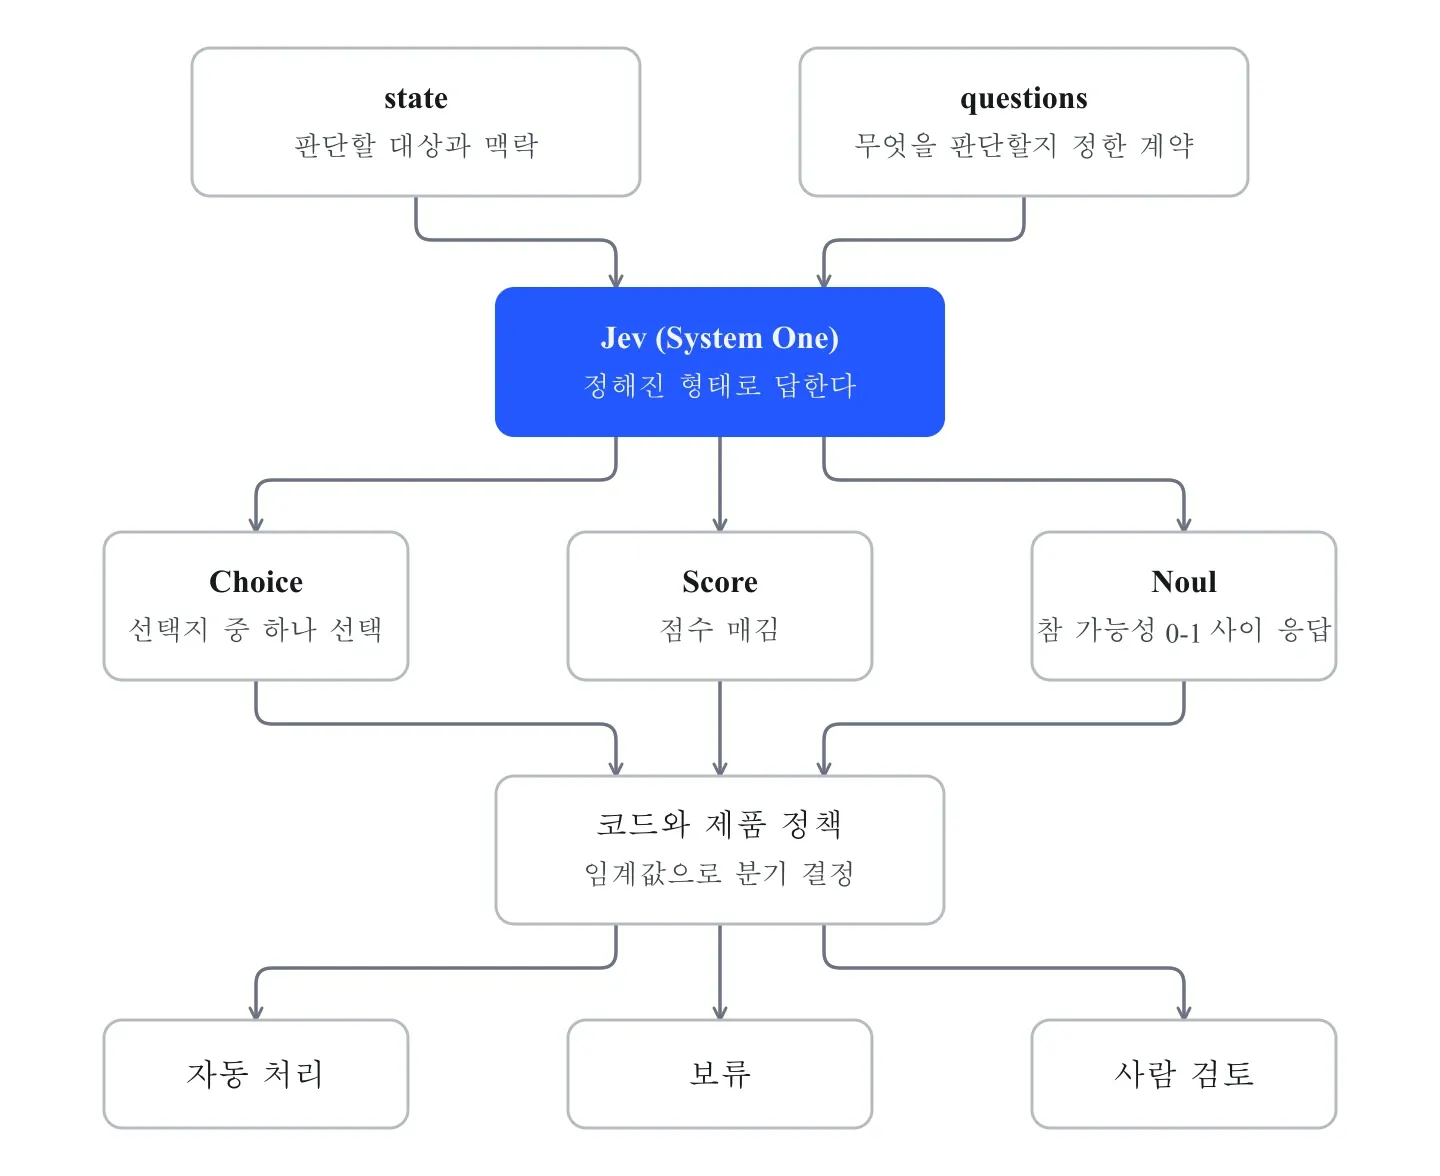
Jev는 state와 questions를 받아 정해진 형태로 답하고, 실제 행동은 코드의 정책이 결정한다.
State, 맥락 알려주기
State에는 평가할 카피뿐 아니라 제품, 독자, 목표처럼 판단에 영향을 주는 맥락을 넣는데, 정해진 표준이 있는것은 아니고 직접 LLM과 대화하며 설계하면 된다. 코드는 대략 아래와 같이 생겼다.
여기서 copy만 넣으면 문장의 표면만 평가하게 된다. targetAudience와 goal을 함께 넣어야 누구에게 어떤 행동을 유도하는 카피인지 판단할 수 있다.
1const state = {
2  product: "1인 창작자를 위한 콘텐츠 제작 도구",
3  targetAudience: "AI로 제품을 만들고 출시하려는 1인 창작자",
4  goal: "무료 체험 시작",
5

6  copy: {
7    headline: "아이디어를 오늘 출시할 제품으로 바꾸세요",
8    description: "기획부터 콘텐츠 제작까지 한곳에서 진행합니다",
9  },
10

11  constraints: {
12    avoidClaims: [
13      "성과를 보장하는 표현",
14      "확인되지 않은 수치",
15    ],
16  },
17};
만약 이메일을 판단하는 로직을 만든다면 state에는 발신자, 제목, 본문, 앞선 대화, 현재 진행 중인 프로젝트, 기한 정보가 후보다. 원칙은 많이 넣는 것이 아니라 그 판단에 영향을 주는 정보만 넣는 것이다.
Questions, 판단 기준 알려주기
Questions에는 이 카피를 어떤 기준으로 판단할지 정의한다.
1// Questions: 어떤 기준으로 판단할지 정의
2const questions = {
3  // 판단 기준들을 여기에 나열
4};
questions 안에 들어가는 판단 기준들은 세 가지 타입이 있다.
Choice : 객관식 선택지중 하나로 응답
질문과 함께 객관식 선택지를 제공하며, Jev는 주어진 정보에 대해 정의된 질문을 하고, 객관식으로 정의된 답변 중 하나를 선택해 응답한다.
1const questions = {
2  // Choice: 목록에 넣은 선택지 중 하나를 골라줌
3  primaryMessage: choice(
4    "이 카피가 가장 먼저 전달하는 가치는 무엇인가?",
5    {
6      speed: "제품을 더 빠르게 출시할 수 있다",
7      simplicity: "복잡한 제작 과정을 단순하게 만들 수 있다",
8      quality: "콘텐츠의 완성도를 높일 수 있다",
9      unclear: "핵심 가치를 분명하게 파악하기 어렵다",
10    },
11  ),
12};
Score : 점수로 응답
질문과 함께 2개에서 최대 10개의 단계를 정의할 수 있으며, 첫 번째 단계는 0점, 그 뒤로 1점씩 올라가는 형태로 구성한다.
단계 수를 늘리는 것보다 각 단계를 서로 명확하게 구별할 수 있도록 설명하는 것이 중요하다.
1const questions = {
2  ...
3  // Score: 점수로 매겨짐.
4  clarity: score(
5    "타깃 사용자가 제품의 가치와 다음 행동을 얼마나 쉽게 이해할 수 있는가?",
6    [
7      "제품과 다음 행동을 모두 파악하기 어렵다", //0점
8      "제품의 용도는 보이지만 다음 행동이 불분명하다", //1점
9      "제품의 가치와 다음 행동을 바로 이해할 수 있다", //2점
10      //각 단계를 구별할 수 있는 수준으로만 구성한다.
11    ],
12  ),
13};
Noul, 참일 가능성을 0~1 값으로 응답
Noul에는 판단할 질문을 넣는다. 응답은 질문에서 묻는 명제가 참일 가능성을 나타내는 0~1 사이 값이다. ‘근거 없이 성과를 보장하거나 과장하는 표현이 있는가?’라는 질문이라면 1에 가까울수록 그런 표현이 있을 가능성을 높게 판단한 것이다. 0에 가깝다는 것은 그 가능성을 낮게 판단했다는 뜻이다. 이 값을 기준으로 통과, 보류, 재작성을 결정하는 임계값은 코드와 제품 정책에서 정한다.
1  questions: {
2    ...
3    // Noul: 참일 가능성을 0~1 값으로 응답
4    overclaim: noul(
5      "근거 없이 성과를 보장하거나 과장하는 표현이 있는가?",
6    ),
7  },
Jev의 응답 결과, 행동으로 연결하기
Jev의 응답 결과
앞에서 정의한 state와 questions를 Jev에 전달하면 각 질문에 대한 답을 받는다. Choice와 Score는 판단의 confidence도 함께 반환한다. confidence가 낮다면 Jev가 판단을 했지만 확신이 낮다는 뜻이다. Noul은 별도 confidence 없이 0~1 사이의 값 자체가 참일 가능성을 표현한다.
아래는 이 글에서 사용한 Hero 카피를 평가했을 때의 예시다. 실제 값은 카피와 맥락이 달라지면 함께 달라진다.
1const result = await client.systemOne({
2  state,
3  questions,
4});
5

6console.log(result.answers);
7

8// {
9//   primaryMessage: {
10//     choice: "speed", //"제품을 더 빠르게 출시할 수 있다"
11//     confidence: 0.91, //꽤나 확신 있는 편
12//   },
13//   clarity: {
14//     score: 2, //"제품의 가치와 다음 행동을 바로 이해할 수 있다"
15//     confidence: 0.87,
16//   },
17//   overclaim: {
18//     noul: 0.2, //"근거 없이 성과를 보장하거나 과장하는 표현이 있는가?"에 대한 대답
19//   },
20// }
이 결과는 카피의 핵심 메시지를 speed, 즉 더 빠른 출시로 읽었다는 뜻이다. clarity.score가 2라면 앞에서 만든 3단계 척도 중 마지막 단계에 해당하므로, 제품의 가치와 무료 체험이라는 다음 행동이 비교적 분명하다고 판단한 것이다. overclaim.noul이 0.2이므로 근거 없는 성과 보장이나 과장 표현은 발견하지 못했다.
Jev의 판단을 행동으로 연결하기
Jev는 판단만 한다. 예를 들어 카피를 넣고 Jev를 위와 같은 판단 기준을 거쳐 평가한 결과를 보고 어느 값부터 자동으로 처리하고 어느 구간을 사람에게 넘길지는 코드와 제품 정책이 정한다.
예를 들어 ‘조치가 필요한가’라는 Noul 값이 0.85 이상이면 알림을 보내고, 0.6 이상 0.85 미만이면 검토 대기열에 넣고, 그 아래는 낮은 우선순위로 보관하는 식이다. 이 기준은 정하기 나름이다.
LLM이 만들고, Jev가 판단하고, 코드가 행동한다
LLM과 Jev는 경쟁 관계가 아닌 분업 관계다. 가장 자연스러운 조합은 LLM이 후보를 만들고, Jev가 같은 기준으로 평가하고, 코드가 결과에 따라 다음 행동을 고르는 구조다.
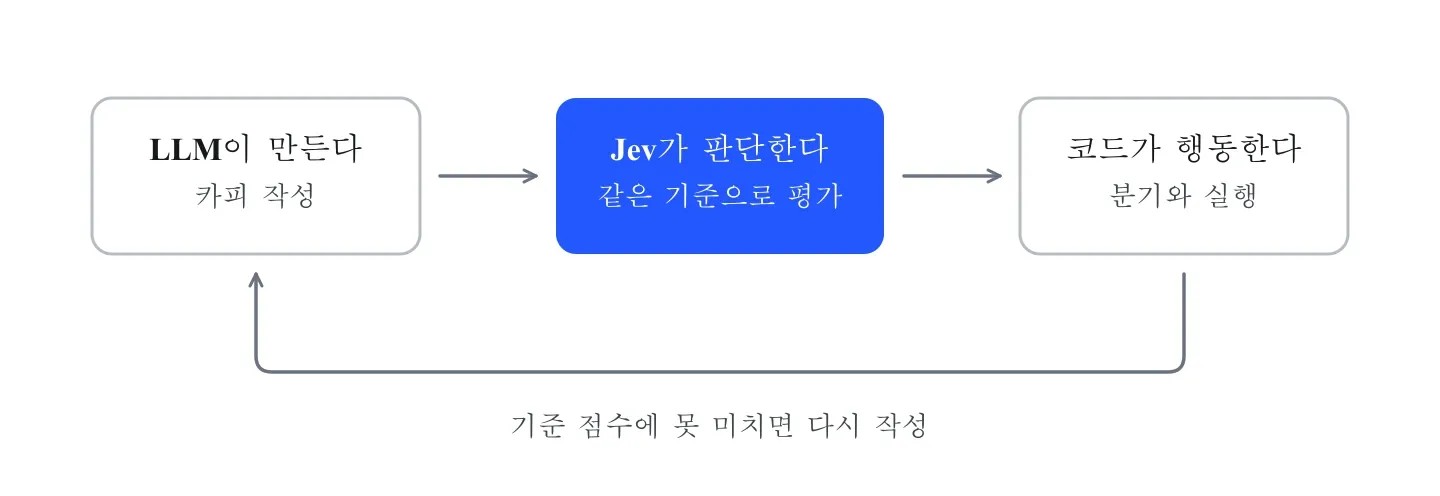
LLM, Jev, 코드가 역할을 나누고, 기준에 못 미친 결과는 LLM의 재작성으로 돌아간다.
Jev가 잘 맞는 일과 맞지 않는 일
Jev에 잘 맞는 문제는 다음 네 조건을 동시에 많이 만족한다.
- 출력 후보가 미리 정해져 있다.
- 같은 판단을 자주 반복한다.
- 판단 결과를 코드가 바로 사용한다.
- 애매한 경우를 확률로 구분해 사람에게 넘길 필요가 있다.
| 아이디어 | Jev가 맡는 판단 | LLM과 코드가 맡는 일 |
|---|---|---|
| 이메일 액션 알리미 | 조치 필요, 긴급도, 이메일 유형 | Gmail 조회, 요약, Discord 알림 |
| 콘텐츠 hook 평가기 | hook, 관련성, 구체성, retention | 카피 생성과 재작성, 결과 저장 |
| SEO 제목 검토기 | 검색 의도 일치, 명확성, 과장 위험 | 키워드 데이터 조회, 제목 생성 |
| 개인화 학습 추천 | 사용자와 자료의 적합성 | 후보 검색, 추천 이유 생성 |
| 고객 문의 라우터 | 의도, 담당 부서, 긴급도 | 티켓 생성과 담당자 배정 |
| 회의 후속 작업 추출기 | 실제 조치가 필요한 문장인지 판단 | 회의록 파싱, Task 등록 |
| 커뮤니티 검토 도구 | 승인, 보류, 사람 검토 필요 | 게시와 알림, 운영 로그 기록 |
| Agent 작업 gate | 요청이 안전하게 자동 실행 가능한지 판단 | 계획 수립, 도구 호출, 승인 요청 |
반대로 한 번만 하는 복잡한 분석, 열린 브레인스토밍, 새로운 유형 발견, 긴 설명 작성은 일반 LLM이 더 자연스럽다. 대규모 원시 데이터의 집계, 검색, 통계 계산도 코드와 데이터베이스의 일이다.
Jev에는 집계 결과처럼 작고 관련성 높은 상태만 넘긴다. 고객 전체 이벤트를 넣는 대신 SQL로 최근 행동을 요약한 뒤 ‘이 사용자는 이탈 위험이 높은가’를 묻는 식이다. 안전이 걸린 실시간 제어도 맞지 않는다. Jev는 카메라와 센서 입력을 처리하는 인식 모델이 아니고, 실시간 제어에 필요한 결정성, 지연 보장, 안전 인증을 대신하지 않는다. 자율주행이라면 제동이나 조향이 아니라 주행 로그의 위험 장면 분류나 사람이 검토할 이벤트 선별 같은 비동기 보조 판단에서 검토해 볼 수 있다.
판단 기준은 데이터로 다듬어진다
Jev가 판단 기준을 알아서 완성해 주지는 않는다. LLM이 초안을 제안할 수는 있지만, 업무 목적과 실패 비용에 맞는지는 제품을 만드는 사람이 검토해야 한다. 현실적인 순서는 다음과 같다.
- 실제 입력 사례를 20개에서 50개 정도 모은다.
- 사람이 각 사례에 원하는 판단과 근거를 표시한다.
- 판단을 한 문장으로 답할 수 있는 작은 질문으로 나눈다.
- Score 단계마다 관찰할 수 있는 차이를 적는다.
- 자동 처리하면 위험한 사례는 명시적인 보류 경로로 보낸다.
- Jev의 결과와 사람의 판단을 비교한다.
- 오답이 반복되는 지점에서 질문, state, 임계값을 고친다.
질문과 임계값은 한 파일에 모아 사람이 검토하기 쉽게 두고, 모델의 판단을 권한 승인으로 쓰지 않는다. 모델의 점수와 실제 성과를 함께 저장해야 기준이 나아지고, 품질은 인상비평이 아니라 사람이 라벨링한 사례와 실제 결과로 검증한다.
마무리
정리하면 LLM은 만들고, Jev는 판단하고, 코드는 행동한다. AI 제품의 품질은 생성 모델 하나로 결정되지 않는다. 생성 전후에 반복되는 작은 판단을 얼마나 명시적이고 재사용 가능한 모듈로 만드느냐가 그 품질을 좌우한다.
Jev를 활용한 다양한 사례들이 쌓이고있는 웹사이트 두 개가 있으니 다른 사람들은 Jev를 어떤 용도로 쓰고 있는지 궁금하다면 참고해보자.